

En bref
Projet : reprise en main de l’hébergement et migration d’une dizaine de sites WordPress (sites personnels, sites clients et lawebfactory.com) vers une infrastructure unique administrée par mes soins, en septembre 2026.
Problème : des sites répartis chez plusieurs prestataires, une dépendance à un administrateur technique externe et aucune vue d’ensemble sur l’état des serveurs, des certificats et des performances.
Risques : perte de trafic, erreurs DNS, certificats SSL invalides, pages désindexées, formulaires et e-mails hors service.
Méthode : inventaire, sauvegarde vérifiée, migration technique, bascule DNS contrôlée, contrôles SEO, puis supervision.
Contrôles : surveillance continue de la disponibilité avec alertes, statut HTTP, HTTPS et certificat, redirections www / sans www, balise robots, sitemap, formulaires, e-mails, temps de réponse.
Résultat à la date de publication : huit sites migrés et clôturés (technique, DNS, SSL et messagerie vérifiés), les autres en cours de bascule, et un tableau de supervision interne qui suit l’ensemble du parc.
Cette étude de cas documente un chantier réel : la reprise de l’hébergement de plusieurs sites dont j’assure le référencement, et leur migration vers une infrastructure que j’administre directement. Ce n’est pas un guide théorique. La méthode générale d’une migration est détaillée dans mon protocole de migration SEO en 14 jours, et les points de contrôle d’une refonte dans la checklist refonte SEO en 47 points. Ici, je montre ce qui s’est réellement passé : l’ordre des opérations, les incidents rencontrés, la façon dont ils ont été détectés et corrigés, et le dispositif de supervision construit ensuite.
Certains sites appartiennent à des clients. Ils sont anonymisés : je décris leur type d’activité et leur configuration technique, pas leur identité.
Pourquoi reprendre la maîtrise de l’infrastructure
Pendant plusieurs années, une partie des sites que j’accompagne en SEO était hébergée chez des tiers : hébergeurs mutualisés, plateformes propriétaires, ou serveurs gérés par un administrateur technique externe. Ce modèle fonctionne tant que tout va bien. Il devient un frein dès qu’il faut agir vite : un certificat qui expire, un site lent, une page désindexée par erreur, une modification DNS à faire avant une mise en ligne.
Pour un consultant SEO, cette dépendance a un coût concret. Chaque diagnostic technique passe par un intermédiaire. Les délais s’allongent. Et surtout, il est impossible d’avoir une vue d’ensemble : quel site tourne sur quelle version de PHP, quel certificat se renouvelle réellement, quelle base de données n’a pas été sauvegardée depuis des semaines.
J’ai donc décidé de centraliser progressivement les sites sur une infrastructure unique, un hébergement cloud sous cPanel, découpé en plusieurs comptes distincts pour cloisonner les sites entre eux. L’objectif n’était pas de réduire les coûts, mais de gagner trois choses : la réactivité, la visibilité sur l’état réel de chaque site, et la capacité à reproduire la même procédure de migration à chaque nouveau site.
Ce qui peut casser pendant une migration
Une migration d’hébergement ressemble à une opération purement technique. En pratique, presque chaque étape a une conséquence directe sur le référencement ou sur l’activité du site. Voici les risques que j’ai listés avant de commencer, et que la procédure devait couvrir.
| Risque | Conséquence possible |
|---|---|
| Erreur DNS ou propagation incomplète | Une partie des visiteurs, ou Googlebot, atteint encore l’ancien serveur ; site inaccessible ou incohérent. |
| Domaine avec et sans www mal redirigé | Contenu dupliqué, certificat invalide sur l’une des deux versions. |
| Certificat SSL absent ou auto-signé | Alerte de sécurité dans le navigateur, chute immédiate des visites. |
| Mauvais passage HTTP vers HTTPS | Boucles de redirection, contenus mixtes. |
| Erreurs 404 et redirections perdues | Perte des signaux SEO des anciennes URL. |
| Canonical, robots.txt ou balise robots erronés | Pages retirées de l’index. |
| Sitemap non mis à jour | Exploration ralentie des pages importantes. |
| Base de données incomplète ou mal encodée | Contenus tronqués, réglages perdus. |
| Formulaires et e-mails transactionnels | Demandes de contact perdues sans que personne ne s’en aperçoive. |
| Performances dégradées | Temps de réponse plus long, expérience mobile dégradée. |
| Absence de sauvegarde exploitable | Aucun retour arrière possible en cas d’incident. |
L’inventaire préalable, site par site
Avant de toucher à quoi que ce soit, chaque site a fait l’objet d’un inventaire. C’est l’étape la plus ingrate, et celle qui évite le plus d’incidents. Pour chaque domaine, je relève :
- Le registrar et la zone DNS : qui gère le domaine, où sont les enregistrements, qui a les accès. Sur ce parc, les zones DNS étaient réparties entre plusieurs registrars et une plateforme propriétaire de création de sites.
- Les enregistrements existants : A, AAAA, CNAME, et surtout MX, SPF, DKIM et DMARC. Un site peut changer de serveur alors que sa messagerie reste chez un autre prestataire : ces enregistrements ne doivent pas bouger.
- Les fichiers et la base de données : taille, version de WordPress, thème, extensions, constructeur de pages.
- L’environnement serveur : version de PHP, extensions PHP nécessaires, cache.
- Les certificats : émetteur, domaines couverts, avec et sans www.
- La messagerie et les e-mails transactionnels : boîtes hébergées, envoi des formulaires via SMTP ou service tiers.
- Le suivi : Search Console, Analytics, outils de mesure d’audience.
- Les URL stratégiques : accueil, pages de service, pages qui reçoivent le plus de visites.
- Les formulaires : où arrivent les demandes, qui doit les recevoir.
- Les sauvegardes existantes : leur date réelle, leur contenu, leur emplacement.
Ce dernier point a donné une première surprise. Sur l’un des sites, l’extension de sauvegarde tournait bien, mais les sauvegardes récentes ne contenaient que les fichiers. La dernière copie complète de la base de données datait de deux mois. Rien d’alarmant tant que rien ne casse, mais c’est exactement le genre de trou qu’on découvre le jour où il faut restaurer.
Sauvegarde et plan de retour arrière
Une règle n’a jamais été assouplie : aucune modification sans sauvegarde complète préalable, fichiers et base de données, et sans vérifier que cette sauvegarde est bien terminée et restaurable. Une sauvegarde lancée n’est pas une sauvegarde réussie. Je contrôle donc le journal de l’extension et la présence de chaque composant (base, extensions, thèmes, médias, autres fichiers) avant de passer à la suite.
Le plan de retour arrière repose sur un principe simple : tant que les DNS n’ont pas basculé, l’ancien site reste en ligne et intact. La migration se prépare sur le nouveau serveur sans que les visiteurs ne voient quoi que ce soit. Si un problème apparaît pendant les tests, on corrige ou on abandonne, sans conséquence. Après la bascule, le retour arrière consiste à remettre les enregistrements DNS précédents. D’où l’intérêt de noter les valeurs d’origine avant de les modifier, et de réduire la durée de vie (TTL) des enregistrements concernés pour que ce retour soit rapide.
La migration technique
Pour chaque site, la séquence a été la même :
- Création du domaine sur le compte d’hébergement cible, dans un compte cPanel adapté (les sites sont répartis sur plusieurs comptes pour les cloisonner).
- Transfert des fichiers et de la base de données, puis vérification de la configuration de WordPress.
- Test du site sur le nouveau serveur avant toute bascule, sans modifier la zone DNS publique.
- Abaissement du TTL des enregistrements concernés, puis bascule des enregistrements A (et www) vers le nouveau serveur.
- Vérification de la propagation, puis génération du certificat SSL.
- Activation ou contrôle du cache de pages, après vérification de ce que le serveur prend réellement en charge.
- Tests fonctionnels : pages clés, formulaires, e-mails, administration.
Une règle d’organisation s’est aussi imposée : les modifications DNS sont réalisées par le détenteur des accès au registrar, et je vérifie ensuite chaque enregistrement en lecture. Cela évite qu’une opération sensible soit faite sur un compte dont on ne maîtrise pas l’historique, et laisse une trace claire de qui a fait quoi.
Les incidents rencontrés, et ce qu’ils enseignent
C’est la partie la plus utile de ce retour d’expérience. Aucun de ces incidents n’était spectaculaire, mais chacun aurait pu coûter du trafic ou des demandes de contact s’il était passé inaperçu.
Des certificats auto-signés qui ne se seraient jamais renouvelés
Sur deux sites, le serveur servait un certificat auto-signé au lieu d’un certificat Let’s Encrypt. Le site semblait fonctionner pour qui avait déjà accepté l’exception, mais un visiteur ordinaire voyait une alerte de sécurité. Surtout, ce certificat n’aurait jamais été renouvelé automatiquement.
La cause était la même dans les deux cas : l’outil de génération incluait par défaut un sous-domaine de messagerie qui n’existait pas dans la zone DNS. La validation échouait donc pour l’ensemble de la demande. La correction a consisté à retirer ce sous-domaine de la demande, à lancer une simulation de génération, puis la génération réelle une fois la simulation réussie. Depuis, la simulation préalable fait partie de la procédure.
Un domaine nu qui pointait encore vers l’ancienne plateforme
Sur un site client, anciennement hébergé sur une plateforme propriétaire de création de sites, la version www avait été basculée, mais le domaine sans www pointait encore vers l’ancienne plateforme via une règle de redirection. Conséquence : la génération du certificat échouait systématiquement, car la validation passait par un serveur qui n’était plus le bon.
La correction a demandé de supprimer la règle de redirection de l’ancienne plateforme, puis d’ajouter un enregistrement A pour le domaine nu, avec un TTL court. Les enregistrements de messagerie (MX, SPF, DKIM, DMARC), gérés par un autre prestataire, sont restés strictement intacts. La propagation a été vérifiée, puis le certificat généré.
Une licence liée à l’ancien domaine de préproduction
Sur un autre site, le constructeur de pages signalait une licence invalide après la migration. La licence, mono-site, était restée rattachée à un ancien domaine de préproduction. Il a fallu libérer ce domaine depuis le compte de l’éditeur, avec le titulaire du compte, puis réactiver la licence sur le domaine de production. C’est typiquement un point absent des checklists de migration, et pourtant bloquant pour les mises à jour et le support.
Un site resté en noindex
Un site est sorti de la migration avec une balise robots en noindex, héritée d’un environnement de travail. Le site s’affichait parfaitement. Seul un contrôle explicite de la balise robots sur la page d’accueil l’a révélé, et il a été corrigé avant que les moteurs de recherche ne retirent les pages de l’index. C’est la raison pour laquelle ce contrôle figure en tête de ma liste après bascule.
Des modifications qui semblent enregistrées, mais ne le sont pas
Dernier enseignement, plus discret : sur les sites construits avec un constructeur de pages, modifier le contenu classique d’une page ne change pas son rendu, car le constructeur stocke ses propres données. Et sur un site, un réglage de modèle de page semblait enregistré à l’écran alors qu’il ne l’était pas. Depuis, toute modification est vérifiée après un rechargement complet, et idéalement sur la version publique de la page, jamais sur l’écran d’administration juste après avoir cliqué.
Un cache installé qui ne mettait rien en cache
Dernier constat, fait après la migration de lawebfactory.com : une extension de cache conçue pour un type de serveur web précis était active, mais le serveur réel n’était pas de ce type. L’extension affichait bien ses réglages, sans jamais servir une seule page depuis le cache. Seule la lecture des en-têtes HTTP de réponse, et du rapport de l’extension, l’a révélé. Depuis, je vérifie qu’un cache fonctionne réellement, pas seulement qu’il est activé.
Une migration à sécuriser ?
Changement d’hébergeur, de domaine ou de CMS : je prépare l’inventaire, la sauvegarde, la bascule et les contrôles SEO, pour éviter ce genre d’incident sur votre site.
Migration serveur et migration SEO : deux sujets liés mais distincts
Dans ce chantier, les URL ne changeaient pas : même domaine, mêmes adresses, seul le serveur changeait. C’est le cas le plus simple pour le référencement. Mais « le site s’affiche » ne suffit pas pour conclure qu’il n’y a pas de risque SEO. Pour chaque site, les contrôles SEO ont porté sur :
- le code HTTP des pages stratégiques (200 attendu, sans chaîne de redirection) ;
- la redirection unique vers la version canonique (HTTPS, avec ou sans www selon le choix du site) ;
- la balise canonical des pages clés ;
- la balise robots et le fichier robots.txt ;
- la disponibilité du sitemap XML ;
- les title et le H1 des pages principales ;
- les données structurées déjà en place ;
- le chargement des images et médias ;
- le fonctionnement des formulaires et le suivi statistique ;
- les rapports Search Console dans les jours qui suivent.
Quand une migration change aussi les URL (refonte, fusion de sites, changement de domaine), la partie SEO devient prépondérante : crawl initial, inventaire des URL indexées, table de correspondance, redirections 301, comparaison avant et après. Ce volet est détaillé dans le protocole de migration SEO et dans les recommandations officielles de Google sur les déplacements de site avec modification d’URL et sur les redirections.
Une supervision développée en interne
Une fois les sites regroupés, il fallait pouvoir répondre à tout moment à une question simple : dans quel état est chaque site, et dans quel état est le serveur ? J’ai donc construit mon propre tableau de supervision. Il ne remplace pas les outils des hébergeurs ; il rassemble au même endroit les informations qui comptent pour quelqu’un qui est responsable à la fois du SEO et de l’hébergement.
Voici ce qu’il suit réellement aujourd’hui :
| Domaine suivi | Indicateurs |
|---|---|
| Disponibilité | Statut global de chaque site, code HTTP renvoyé et historique de disponibilité sur sept jours |
| Performance | Temps de réponse moyen sur 24 heures, premier octet et temps de chargement complet |
| PageSpeed | Score PageSpeed mobile et ordinateur, avec LCP, CLS et TBT pour chaque site |
| Sécurité du transport | Présence d’un certificat SSL actif |
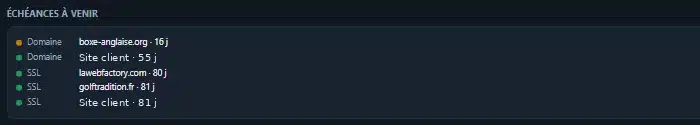
| Échéances | Nombre de jours avant l’expiration des certificats SSL et le renouvellement des noms de domaine |
| Environnement | Version de PHP et extensions installées |
| Ressources | Espace disque par compte, taille des bases de données, bande passante |
| Domaines | Domaines rattachés à chaque compte et redirections en place |
| Historique | Journal des contrôles successifs, avec la méthode de mesure utilisée |
Ce tableau est complété par deux autres niveaux de surveillance. D’abord, une surveillance externe de disponibilité, assurée par des services spécialisés, qui interroge chaque site toutes les trois minutes et m’envoie une alerte par e-mail dès qu’un site ne répond plus, puis une seconde quand il est rétabli. Ensuite, un contrôle quotidien des certificats SSL, des noms de domaine et des enregistrements DNS, dont l’exécution est elle-même surveillée : si le contrôle ne s’est pas exécuté, je suis alerté. Enfin, des contrôles détaillés de performance et d’environnement sont lancés plusieurs fois par semaine, avec un récapitulatif chaque lundi.
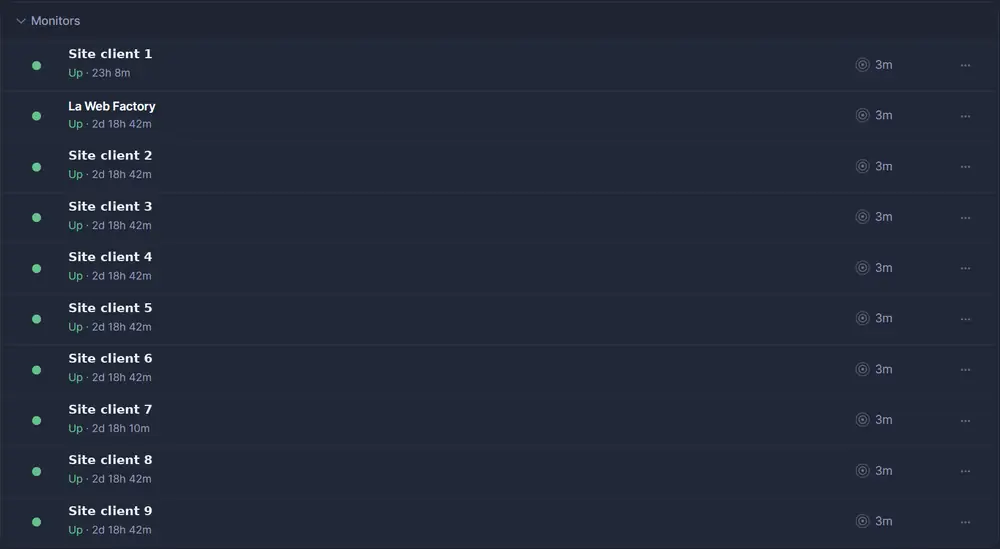
Ces alertes ont déjà servi. Lors d’une mise en maintenance volontaire d’un site, la surveillance a signalé l’indisponibilité en quelques minutes, puis son rétablissement. C’est précisément ce qu’on attend d’elle : ne rien laisser passer, y compris ce qui est prévu.
Son intérêt s’est vu dès les premiers contrôles. C’est en croisant les informations du serveur et des sites que les points suivants ont été relevés : une version de PHP arrivée en fin de support de sécurité, un site sans cache de pages, une base de données encombrée de milliers de révisions, et un taux d’utilisation mémoire du cache PHP à surveiller sur un compte.
Faire superviser votre site
Disponibilité surveillée avec alertes, certificats et domaines contrôlés chaque jour, suivi PageSpeed : c’est inclus dans l’hébergement WordPress administré.
Performances : mesurer avant d’optimiser
La performance a été traitée en deux temps. D’abord un audit de l’environnement de chaque site : version de PHP, cache d’opcodes, version de la base de données, extension de cache. Ensuite, seulement les changements sans risque, précédés d’une sauvegarde : nettoyage de la base de données (plus de 2 400 révisions supprimées sur un site, plus de 1 000 sur un autre, avec optimisation des tables), suppression des anciens dossiers de migration, et mise en place d’un cache là où il manquait.
Après ces interventions, les mesures relevées étaient les suivantes : un temps de réponse serveur de 622 ms pour un chargement complet d’environ 2,1 secondes sur golftradition.fr, et de 517 ms pour un chargement d’environ 2 secondes sur un site client. Je n’ai pas de mesure antérieure réalisée dans les mêmes conditions : je ne présente donc pas de gain « avant / après », seulement l’état constaté.
La montée de version de PHP, elle, n’a pas été faite à chaud. Elle suppose de vérifier la compatibilité du thème et de chaque extension, et reste planifiée comme une intervention distincte. Pour les indicateurs de performance perçus par les utilisateurs, la référence reste PageSpeed Insights et les Core Web Vitals : ils mesurent le chargement, la réactivité et la stabilité de l’affichage, là où le temps de réponse serveur n’en est qu’une composante.
La checklist appliquée après chaque bascule
| Contrôle | Attendu |
|---|---|
| Code HTTP des pages clés | 200, sans chaîne de redirection |
| HTTPS | Certificat valide, émis par une autorité reconnue, sans alerte navigateur |
| www / sans www | Une seule version canonique, l’autre redirigée en 301 |
| Balise robots | index, follow sur les pages publiques |
| robots.txt et sitemap | Accessibles et cohérents |
| Canonical | Pointe vers l’URL publique en HTTPS |
| Erreurs 404 | Aucune sur les pages stratégiques et les médias |
| Formulaires | Envoi testé et réception confirmée |
| E-mails | Enregistrements MX, SPF, DKIM et DMARC inchangés si la messagerie reste ailleurs |
| Statistiques et Search Console | Suivi actif, aucune erreur nouvelle dans les jours suivants |
| Performances | Temps de réponse relevé et comparé au site précédent quand c’est possible |
| Mentions légales | Hébergeur à jour |
Le dernier point est souvent oublié. Après la migration, j’ai vérifié les pages de mentions légales et de politique de confidentialité de dix sites : plusieurs mentionnaient encore l’ancien hébergeur, ou aucun. Neuf ont été corrigées et vérifiées en ligne ; la dernière est en cours de traitement.
Passer de dix sites à plusieurs milliers d’URL
Ce chantier porte sur une dizaine de sites, sans changement d’URL. Mais la logique qui l’a rendu fiable (inventorier, sécuriser, exécuter la même procédure, contrôler systématiquement, superviser) est précisément celle qui permet d’aborder des migrations beaucoup plus volumineuses : fusion de plusieurs sites, changement de CMS, reprise de plusieurs milliers de pages.
Sur un corpus massif, la question n’est plus de tout vérifier à la main, ce qui serait irréaliste, mais de répartir intelligemment le travail entre l’automatisation et la validation humaine :
- Collecte et inventaire : crawl des sites existants et, quand le CMS le permet, extraction par API, croisés avec les données de Search Console et d’audience.
- Qualification : chaque URL reçoit un statut (conserver, fusionner, réécrire, archiver, supprimer, rediriger).
- Table de correspondance : chaque ancienne URL a une destination explicite, ou une justification si elle disparaît.
- Priorisation : un score de criticité combine trafic, impressions et clics, liens entrants externes, liens internes, rôle de la page et risque de perte. Sur la plupart des sites, une faible part des pages concentre l’essentiel des visites : c’est là que se concentre la validation humaine.
- Contrôles automatisés : scripts qui vérifient pour chaque redirection le code renvoyé, l’absence de boucle et de chaîne, la cohérence de la destination et le code 200 de la page cible, ainsi que les liens internes cassés.
- Échantillonnage humain : relecture systématique des pages stratégiques et contrôle par échantillon sur le reste.
- Supervision après mise en ligne : suivi rapproché les premières semaines, puis espacé, des erreurs d’exploration, de l’indexation et des performances.
La méthodologie et les contrôles développés sur ce chantier permettent d’industrialiser une migration sur des corpus beaucoup plus importants, en automatisant les opérations répétitives et en concentrant la validation humaine sur les pages à plus fort enjeu. Je précise que le chantier documenté ici ne portait pas sur plusieurs milliers d’URL : c’est la méthode qui se transpose, pas le volume qui a déjà été traité.
Les enseignements
Une procédure écrite vaut mieux qu’une bonne mémoire. Chaque site a suivi la même séquence, et chaque incident a enrichi la procédure du site suivant : la simulation avant génération de certificat, le contrôle de la balise robots, la vérification après rechargement.
La documentation est un outil de travail. Chaque intervention a été consignée : ce qui a été fait, par qui, avec quel résultat vérifié. C’est ce qui rend les opérations reproductibles, et ce qui permet de répondre précisément à un client qui demande où en est son site.
La supervision transforme la réaction en prévention. Une version de PHP en fin de support, une base encombrée ou un cache absent ne provoquent pas de panne visible. Ils dégradent lentement. Seul un suivi régulier les fait apparaître avant qu’ils ne deviennent un problème.
Maîtriser l’infrastructure raccourcit les délais. Quand le SEO et l’hébergement sont sous la même responsabilité, le temps entre la détection d’un problème et sa correction se compte en heures, et non plus en échanges entre prestataires.
L’hébergement ne fait pas le classement. Un bon hébergement ne garantit aucune position dans Google. Il réduit les risques techniques qui peuvent affecter la disponibilité, les performances, l’exploration et l’indexation d’un site.
Vous préparez une migration, une refonte ou une fusion de sites ?
Changement d’hébergeur, passage à WordPress, refonte, fusion de plusieurs sites ou reprise d’un volume important de contenus : la méthode est la même, seule l’échelle change. Je peux intervenir en amont pour sécuriser la migration, pendant la bascule, ou après la mise en ligne pour la supervision.
Pour aller plus loin : accompagnement SEO d’une refonte, hébergement professionnel administré, ce que doit contenir un audit SEO, et les contenus consacrés au GEO. Pour me présenter votre projet : Maxime Mendiboure, consultant SEO.
À propos de l’auteur
Maxime Mendiboure est consultant SEO indépendant au Pays Basque. Il accompagne des TPE et PME sur le référencement naturel, le GEO, les refontes et les migrations de sites, et administre lui-même l’hébergement et la supervision des sites qu’il suit. Il a remporté le prix du Meilleur Expert SEO aux Codeur Awards 2024 et s’est classé troisième dans la catégorie Meilleur consultant webmarketing aux Codeur Awards 2026.
Parlons de votre projet
Refonte, fusion de sites, migration WordPress ou reprise d’un grand volume de contenus : décrivez-moi votre situation, je vous réponds avec une méthode et un chiffrage adaptés.
Questions fréquentes
Comment migrer un site sans perdre son référencement ?
En séparant deux sujets : la migration technique (serveur, DNS, certificat) et la migration SEO (URL, redirections, balises, indexation). Si les URL ne changent pas, l’essentiel est de garantir la disponibilité, le HTTPS, une version canonique unique et des balises robots correctes. Si les URL changent, il faut en plus une table de correspondance complète et des redirections 301 contrôlées.
Quels éléments DNS faut-il contrôler lors d’un changement d’hébergeur ?
Les enregistrements A et AAAA du domaine et de la version www, les CNAME éventuels, et les enregistrements de messagerie MX, SPF, DKIM et DMARC, qui ne doivent pas être modifiés si la messagerie reste chez un autre prestataire. Il faut aussi noter les valeurs d’origine et réduire le TTL avant la bascule pour pouvoir revenir en arrière rapidement.
Comment vérifier une migration après le changement de serveur ?
En contrôlant le code HTTP des pages clés, la validité du certificat, la redirection vers la version canonique, la balise robots, le sitemap, les formulaires, la réception des e-mails, le suivi statistique et les rapports de la Search Console dans les jours qui suivent.
Pourquoi surveiller les certificats SSL après une migration ?
Parce qu’un certificat peut être présent sans être valide ni renouvelable. Sur ce chantier, deux sites servaient un certificat auto-signé qui ne se serait jamais renouvelé. Un certificat invalide déclenche une alerte dans le navigateur et fait fuir les visiteurs.
Quel est le rôle de PageSpeed Insights après une migration ?
PageSpeed Insights mesure les performances perçues par les utilisateurs, notamment les Core Web Vitals, sur mobile et sur ordinateur. Après une migration, il permet de vérifier que le changement de serveur n’a pas dégradé le chargement, et d’identifier les optimisations prioritaires.
Comment gérer une migration de plusieurs milliers d’URL ?
En automatisant l’inventaire, la qualification, la table de correspondance et le contrôle des redirections, puis en concentrant la validation humaine sur les pages à plus fort enjeu, identifiées par un score de criticité combinant trafic, liens entrants et rôle de la page.
Comment contrôler des redirections 301 en masse ?
Avec des scripts qui testent chaque ancienne URL : code de réponse 301, absence de boucle et de chaîne, destination conforme à la table de correspondance et code 200 sur la page cible. Les anomalies sont listées puis corrigées avant la mise en production.
Quelle différence entre migration serveur et migration SEO ?
La migration serveur déplace un site vers une nouvelle infrastructure sans en changer les adresses. La migration SEO concerne tout ce qui modifie la façon dont les moteurs de recherche voient le site : URL, structure, contenus, redirections, balises. Les deux peuvent avoir lieu en même temps, mais se contrôlent différemment.
Quels indicateurs surveiller après une mise en production ?
La disponibilité et le code HTTP des pages, le temps de réponse du serveur, la validité du certificat, les erreurs 404, l’indexation et la couverture dans la Search Console, les performances mesurées par PageSpeed Insights et le bon fonctionnement des formulaires.